分库分表后,跨表查询怎么死
当前位置:点晴教程→知识管理交流
→『 技术文档交流 』
前阵子帮朋友排查一个线上问题。 他们的电商系统做了分库分表,4 个分片,按用户 ID 取模。上线前一切看起来都很美,压测的时候单表查询也跑得飞起。 结果上线第三天,后台管理系统的一个「查询近 7 天订单并关联用户信息」的接口,把整个库拖垮了。 DBA 抓了个慢 SQL 过来,我看了一眼就笑不出来了。一个看似普通的 JOIN 查询,在分片环境下被放大成了一场灾难。 分库分表解决了「存不下」的问题,但顺手把「查得动」的问题放大了十倍。 今天想跟你聊聊这件事。分库分表之后,原来那些习以为常的跨表查询,到底是怎么一步步死掉的。 01 先回到起点:为什么要分库分表 先别急着骂「你们怎么连这个都没想到」。分库分表这件事,很多团队都是被逼的。 单表数据量到了千万级,MySQL 的查询性能开始明显下降。索引再怎么优化,B+ 树的高度摆在那里。更别说写入压力上来之后,主从延迟、连接数不够,一堆问题接踵而至。 分库分表的思路很直接。 把一张大表拆成 N 张小表,分散到不同的数据库实例上。比如按用户 ID 取模,user_id % 4 = 0 的数据去分片 1,= 1 的去分片 2,以此类推。 这样一来,每个分片的数据量只有原来的 1/N,查询速度自然上去了。写入也分摊到了多台机器,瓶颈被打开。 一切看起来都很美好。 直到你需要做一次跨表查询。 02 七宗罪:跨表查询的七种死法
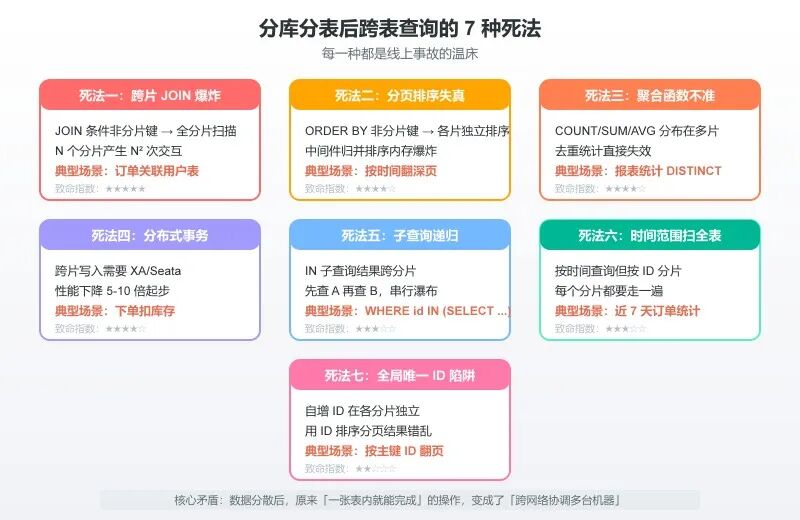
分库分表后跨表查询的七种典型问题 死法一:跨片 JOIN,笛卡尔积爆炸 这是最经典、也最致命的一种。 假设你有订单表和用户表,都按 user_id 做了 4 分片。现在你想查「订单金额大于 100 的订单及其对应的用户信息」。 在单库时代,这就是一条简单的 INNER JOIN。数据库内部用嵌套循环或哈希连接就搞定了。 分片之后呢。
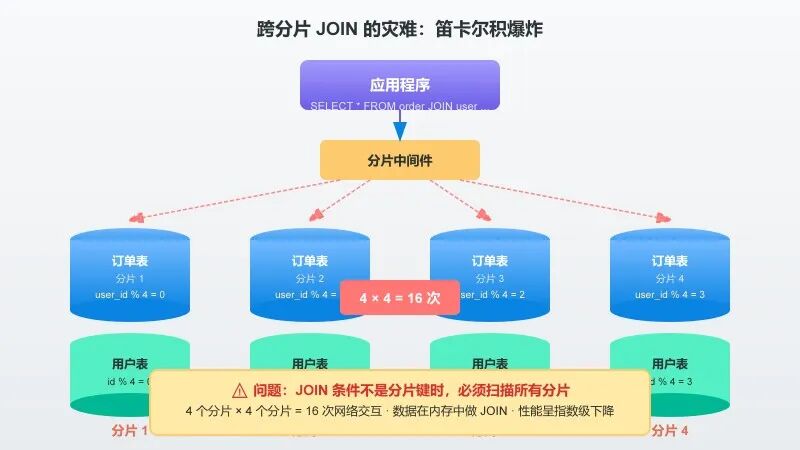
跨分片 JOIN 的网络交互复杂度 订单表的 4 个分片里都有满足条件的数据,用户表的 4 个分片里也都有数据。要完成 JOIN,中间件需要把所有分片的订单数据和所有分片的用户数据都捞出来,在内存里做关联。 4 个订单分片 × 4 个用户分片 = 16 次网络交互。 这还只是 4 个分片的情况。如果是 16 个分片,那就是 256 次。数据量稍微大一点,中间件的内存直接爆。 更坑的是,很多分片中间件对这种情况的处理方式是「先拉回来再说」。表面上你写的是一条 SQL,实际上它在背后偷偷扫了全部分片。你看监控还以为是慢查询,其实是分布式灾难。 死法二:分页排序,越翻越慢 分页查询在分片环境下也是个重灾区。 比如你要查「按创建时间倒序的第 100 页,每页 20 条」。单库的时候,MySQL 只要找到对应位置取 20 条就行。 分片之后呢。每个分片都有自己的「前 2000 条」,但全局第 2000 条在哪,谁也不知道。 中间件的做法是,从每个分片取前 2000 条,然后在内存里做归并排序,再取全局的第 2000-2020 条。 翻到第 100 页,你以为只查了 20 条,实际上查了 2000 × 4 = 8000 条,还要在内存里排序。 翻到第 1000 页呢。自己算吧。 这也是为什么很多做了分库分表的系统,后台列表都不允许深翻页,只能按条件筛选。不是产品不想做,是技术上真的扛不住。 死法三:聚合统计,结果可能是错的 COUNT、SUM、AVG、MAX、MIN……这些在单库时代再普通不过的聚合函数,分片之后也要打个问号。 简单的 COUNT 还好,把各分片的结果加起来就行。但如果带上了 DISTINCT 呢。 「统计最近一个月有多少独立用户下单」——每个分片算出来的 DISTINCT user_id,是不能直接相加的。同一个用户可能在多个分片都有订单(如果分片键不是 user_id 的话),加起来就重复了。 AVG 也有类似的问题。各分片的平均值不能直接平均,得先拿 SUM 和 COUNT,再全局计算。遇到分组聚合 GROUP BY,复杂度再升一级。 很多团队上线后才发现,报表数据对不上。查来查去,是分片后的聚合逻辑有坑。 死法四:分布式事务,性能膝盖斩 严格来说这不是「查询」的问题,但它和跨表操作密切相关,而且杀伤力极大,必须提一下。 单库时代,一个事务就能搞定的事,分片之后可能变成跨多个数据库的分布式事务。XA 协议、两阶段提交、Seata……听起来都很专业,但它们有一个共同的特点。 慢。 不是慢一点,是慢 5 到 10 倍起步。而且随着分片数增加,协调成本还会继续上升。 所以你会看到,做了分库分表的系统,往往同时引入了柔性事务、最终一致性、消息队列补偿这些东西。不是大家喜欢折腾,是硬扛分布式事务的代价太高了。 死法五:子查询,瀑布式串行 WHERE id IN (SELECT ...) 这种子查询,在分片环境下经常变成性能杀手。 比如「查某个地区所有用户的订单」。先从用户表按地区查出一批 user_id,再用这些 user_id 去订单表查数据。 单库的时候,MySQL 的优化器可能会把它改写成 JOIN,或者用半连接优化。 分片之后,中间件的处理方式往往比较朴素。先执行子查询拿到 id 列表,再把这些 id 分到对应的分片去查主表。 如果子查询查出来几千个 id,分散在不同分片上,那就是一轮又一轮的网络往返。像瀑布一样,一层一层往下掉。 死法六:时间范围查询,全分片扫描 这个问题特别常见。很多团队按用户 ID 分片,但运营和后台经常需要按时间范围查数据。 「最近 7 天的订单统计」「昨天的新增用户」——这些查询条件里没有分片键 user_id,中间件没办法路由到具体的分片。 怎么办。只能所有分片都查一遍。 4 个分片还好,16 个分片呢。32 个呢。一个看似普通的时间范围查询,背后可能是几十次数据库请求同时打出去。 而且这种查询往往是后台运营在用,他们可不管你分不分片,只知道「我要导昨天的数据」。一旦有人同时跑几个大报表,数据库连接池瞬间被打满。 死法七:全局 ID 排序,分页结果错乱 这个坑比较隐蔽,但踩中的人不少。 分库分表之后,每个分片的自增 ID 是独立的。分片 1 有 id=1,2,3...,分片 2 也有 id=1,2,3...。大家各算各的,互不干扰。 问题出在「按 ID 排序分页」上。 如果你按主键 ID 排序翻页,每个分片返回的都是自己分片内排序的结果。中间件归并之后,全局顺序其实是乱的。因为不同分片的相同 ID 代表的是不同的数据,它们的创建时间可能差很远。 这也是为什么分库分表的系统都需要一个全局唯一 ID 生成方案——雪花算法、号段模式、UUID,选一个吧。但即便用了全局 ID,按 ID 排序翻页的性能问题还是存在的。 03 怎么解:五种应对策略
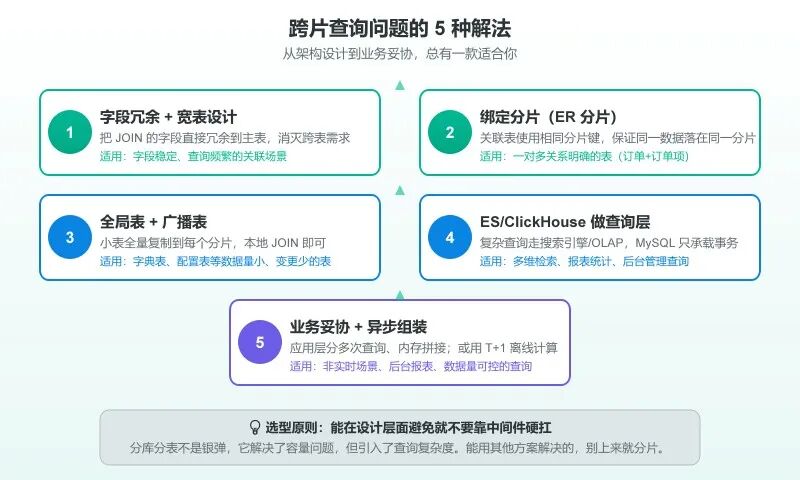
从架构设计到业务妥协的五种解决方案 方案一:字段冗余,消灭 JOIN 这是最朴素也最有效的办法。 订单表查出来之后还要关联用户表拿用户名。那把用户名直接冗余到订单表里行不行。 当然行。代价是数据有冗余,用户改名字的时候要同步更新订单表。但如果这个字段不经常变,或者对一致性要求不是绝对严格,那性价比极高。 能用空间换时间的,就别用复杂度换时间。 方案二:绑定分片,让关联数据落在一处 订单表和订单项表,都按 order_id 分片。同一个订单的所有订单项,肯定和订单主记录在同一个分片里。这样 JOIN 的时候就只需要查一个分片,跟单库没区别。 这种思路叫「ER 分片」或者「绑定表」。核心原则是:有强关联关系的表,用相同的分片键。 不是所有表都能这么做,但能用的地方一定要用上。 方案三:全局表 / 广播表 字典表、配置表、地区表……这些数据量小、变更少、但又经常需要 JOIN 的表,可以做成「全局表」。 意思是,每个分片都存一份完整的数据。查询的时候直接在本地 JOIN,不用跨片。 代价是写入的时候要同步更新所有分片,所以只适合数据量小、写入频率低的场景。 方案四:用 ES / ClickHouse 做查询层 这是现在越来越多团队的选择。 MySQL 只负责承载在线事务,保证数据一致性和写入性能。复杂查询、多维检索、报表统计,全部甩给 Elasticsearch 或者 ClickHouse。 通过双写或者订阅 binlog 的方式把数据同步过去。查询的时候直接走 ES/CK,想怎么 JOIN 怎么聚合都行,反正它们就是干这个的。 这套方案的好处是彻底解耦,MySQL 专心做 OLTP,查询层专心做 OLAP。缺点是架构复杂度上去了,多了一套系统要维护。 方案五:业务妥协,应用层组装 有些场景,与其在数据库层硬扛,不如在业务上做妥协。 比如后台报表,不是实时的行不行。T+1 行不行。如果可以,那用离线计算跑定时任务,把结果存到汇总表里,直接查汇总表就行。 再比如一些查询频率不高的接口,在应用层分两次查,内存里拼一下。慢点就慢点,反正用的人少,也不影响核心链路。 技术方案不是越高级越好,合适最重要。 04 最后说几句心里话 我一直觉得,分库分表是架构里典型的「按下葫芦浮起瓢」。 它解决了存储容量和写入瓶颈,但同时把查询复杂度、运维复杂度、数据一致性的问题都放大了。原来一个数据库能搞定的事,现在要协调一堆数据库。 所以我的建议一直是:能不分就不分,能晚分就晚分。 单库性能还没到瓶颈的时候,先把索引优化好、把缓存用好、把读写分离做好。这些手段都用尽了,再考虑分片。 真到了要分的那一步,也别急着上来就 16 个分片 32 个分片。先从 2 个、4 个开始,预留好扩容空间。分片数越多,上面说的那些问题就越严重。 最关键的是,分片之前就要把查询场景盘清楚。哪些查询走分片键、哪些需要冗余字段、哪些要走 ES、哪些后台查询可以妥协……这些问题不想清楚就硬上,早晚要出事故。 分库分表不是银弹,它只是把问题从「存储」转移到了「查询」。转移的成本,比你想象的高得多。 以上就是我踩过的一些坑,总结出来分享给你。如果你也有分库分表的血泪史,欢迎在评论区聊聊。 END 阅读原文:点击这里 该文章在 2026/10/22 12:41:53 编辑过 |
关键字查询
相关文章
正在查询... 
|


 400 186 1886