技术是理性的,但当流量经过的每一个节点都能被精确编排时,网关也可以很性感。第一次接触OpenResty时,我把它理解成“支持Lua的Nginx”。
于是,我很自然地写出了这样的代码:
ngx.say("hello, OpenResty")
它能运行,也足够惊艳。但如果理解停在这里,OpenResty就只是一个更灵活的模板引擎。
真正进入生产之后,问题会迅速变成另一副模样:
这些问题的答案,不在Lua语法里,而在Nginx的事件模型里。
这篇文章不只教你“怎么写Lua”,而是尝试回答一个更有价值的问题:
如何在不破坏Nginx高并发模型的前提下,把OpenResty变成一台真正可编程的网关?一、OpenResty到底是什么?
OpenResty不是重新实现了一套Web服务器。
它以Nginx为核心,集成了LuaJIT、ngx_http_lua_module以及一组常用的Lua库,让Lua协程能够进入Nginx的事件循环。
可以把它拆成三层:
Nginx → 连接管理、事件循环、反向代理、TLSngx_lua → 把Lua挂载到Nginx不同处理阶段LuaJIT/Resty库 → 业务决策、非阻塞访问、扩展能力
所以它真正擅长的,不是替代Java、Go去承载复杂领域业务,而是在离流量最近的位置做轻量、快速、可动态调整的决策:
身份认证与签名校验;
API限流与并发控制;
灰度发布和动态路由;
请求头、响应头改写;
多级缓存与防缓存击穿;
WAF规则、Bot识别和租户隔离;
网关层日志、指标与链路信息注入。
截至本文写作时,OpenResty官方下载页列出的最新正式版为1.31.1.1。实际部署时建议使用官方发行包或官方容器镜像,并锁定明确版本,而不是自行拼装Nginx、LuaJIT和第三方模块。
二、真正的入门门槛:理解Nginx执行阶段
一个HTTP请求进入Nginx后,并不是从配置文件第一行顺序执行到最后一行。
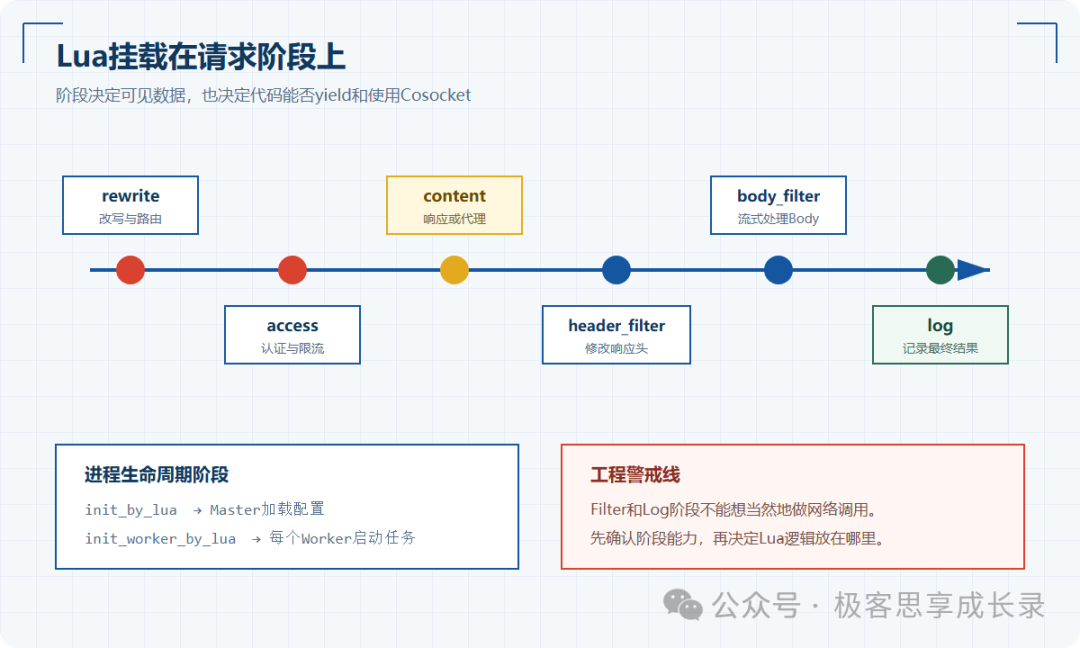
它会经过一组固定阶段。Lua指令的本质,就是把回调函数挂到其中某个阶段。
| | |
|---|
init_by_lua* | | |
init_worker_by_lua* | | |
rewrite_by_lua* | | |
access_by_lua* | | |
content_by_lua* | | |
balancer_by_lua* | | |
header_filter_by_lua* | | |
body_filter_by_lua* | | |
log_by_lua* | | |
这里最重要的不是记表格,而是建立两个判断:
这段逻辑最早在哪个阶段拥有足够信息?
这个阶段是否允许代码挂起并等待网络I/O?
例如,身份认证放在access阶段很自然,因为它应该发生在请求进入上游之前;响应头修改则应该放在header_filter阶段。
如果把远程鉴权请求塞进不能yield的过滤阶段,即使语法能组织出来,运行模型也已经错了。
OpenResty的能力很强,但每一种能力都有阶段边界。
三、先跑起来:一个包含认证、限流和灰度路由的网关
它包含一个OpenResty网关和两个模拟后端。安装Docker后,在demo目录执行:
curl -i http://localhost:8080/api/orders
响应状态应该是401。
携带演示Token再次访问:
-H "Authorization: Bearer demo-secret" \ http://localhost:8080/api/orders
网关会按照百分比把请求分配到backend-a或backend-b。也可以用请求头强制进入B组:
-H "Authorization: Bearer demo-secret" \ http://localhost:8080/api/orders
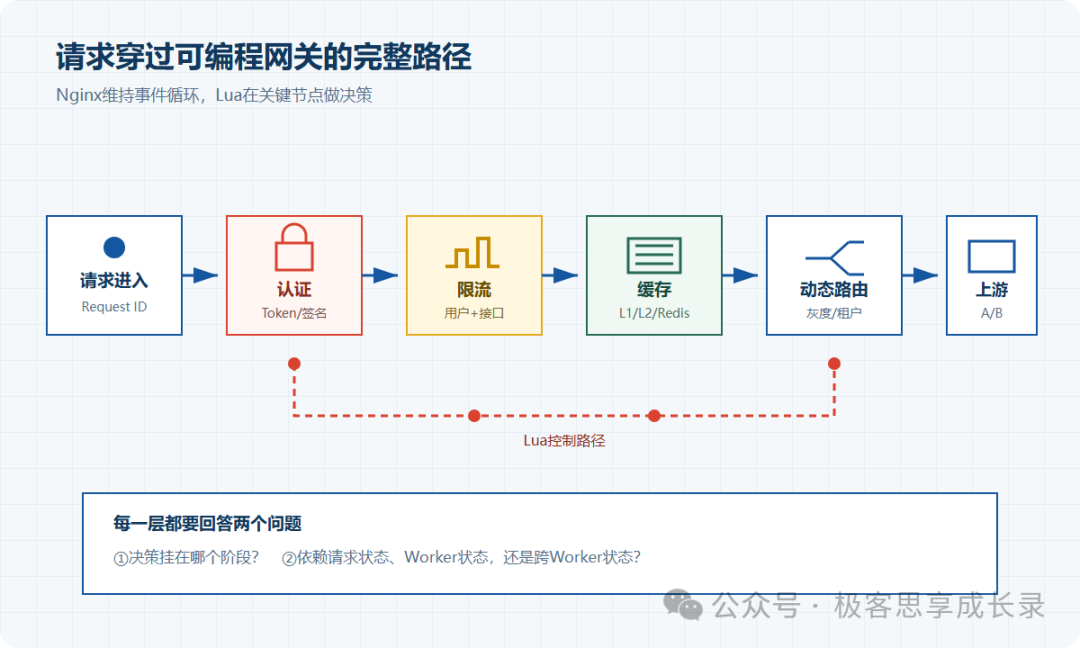
响应头中的X-Gateway-Route会告诉你最终选择了哪个后端。Demo中的固定Token只用于展示阶段编排,不能直接用于生产。真实系统应接入经过审计的JWT/OIDC方案,并正确处理签名算法、密钥轮换、过期时间和重放风险。四、一条请求,如何穿过这台网关?
require("router").select() require("limiter").check()proxy_pass http://$backend$request_uri;header_filter_by_lua_block { ngx.header["X-Gateway-Route"] = ngx.ctx.route ngx.header["X-Request-Id"] = ngx.var.request_id
表面上看,它只是几段Lua;从执行阶段看,却是一条清晰的流水线:
ngx.ctx.user = "demo-user"ngx.ctx.route = "backend-b"
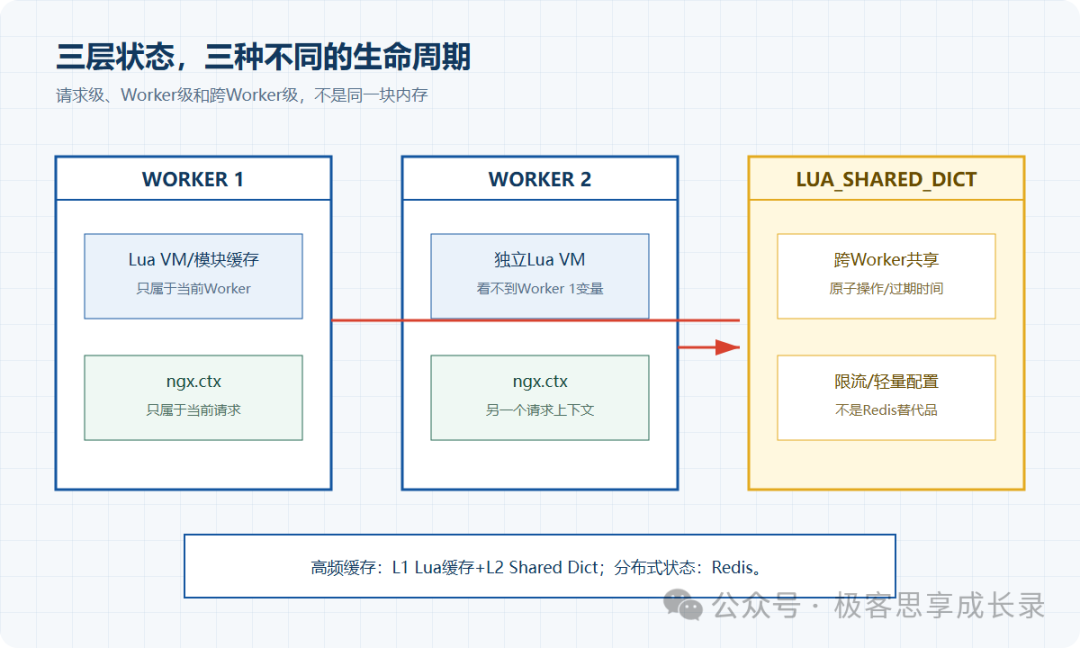
ngx.ctx只属于当前请求,适合在多个阶段之间传递轻量状态。认证阶段写入的用户信息,后续路由、日志阶段都可以读取。
不要把它理解成全局变量,也不要存放巨大的响应体。子请求、内部跳转等场景还可能拥有不同的上下文边界,使用前需要结合实际调用链验证。
五、进阶能力一:用Shared Dict实现跨Worker状态
Nginx通常会启动多个Worker进程。
每个Worker拥有独立Lua VM,因此下面这段代码并不能实现全局计数:
它只修改当前Worker中的变量,其他Worker完全看不到。需要跨Worker共享时,可以在Nginx配置中声明一块共享内存:
lua_shared_dict gateway_limit 10m;lua_shared_dict route_config 1m;
local routes = ngx.shared.route_configroutes:set("beta_percent", 20)local percent = routes:get("beta_percent")
Shared Dict适合:
限流计数器;
短期缓存;
动态开关和版本号;
Worker之间共享的轻量配置;
分布式锁之前的进程内快速判断。
但它不是Redis的平替。
它的容量在启动时固定,数据只存在当前Nginx实例内,复杂数据通常还需要序列化。多台OpenResty之间要共享状态,仍然需要Redis、配置中心或其他外部系统。
更实用的缓存结构通常是:
L1:lua-resty-lrucache,Worker内,无锁、最快L2:lua_shared_dict,跨Worker共享
为了防止热点Key同时失效造成缓存击穿,还应配合lua-resty-lock或“旧值续命+后台刷新”策略,而不是让所有请求一起回源。六、进阶能力二:限流不是一个if判断
Demo使用OpenResty官方维护的lua-resty-limit-traffic:
local limit_req = require"resty.limit.req"local limiter = assert(limit_req.new("gateway_limit", 5, 10))local key = ngx.var.binary_remote_addr .. ":" .. ngx.ctx.userlocal delay, err = limiter:incoming(key, true)return ngx.exit(ngx.HTTP_TOO_MANY_REQUESTS)return ngx.exit(ngx.HTTP_INTERNAL_SERVER_ERROR)
5表示平均每秒允许5个请求,10表示可以被延迟处理的突发容量。超过硬上限时,incoming()返回rejected。
这里有三个容易忽略的设计点。
1.限流Key决定了公平性
按IP限流可能误伤NAT后面的整家公司;按用户限流可能让未登录接口失去保护;按接口限流又可能遗漏高成本参数。
真实Key通常是组合维度:
2.延迟和拒绝是两种策略
在突发容量内,限流器返回一个等待时间。你可以用ngx.sleep()让请求平滑通过;超过硬上限再返回429。
这比“达到阈值全部拒绝”更能吸收短暂抖动。
3.失败时要决定Fail Open还是Fail Closed
如果限流组件自身出错,是放行请求还是拒绝请求?
登录、支付等高风险接口可能倾向Fail Closed;公开读接口为了可用性可能选择Fail Open。这个决定必须显式写进策略,而不是让异常分支替你决定。
七、进阶能力三:Cosocket为什么看起来同步,却没有阻塞Worker?
传统LuaSocket的调用模型是阻塞的。如果在Nginx Worker里直接发起阻塞网络请求,当前Worker中的其他连接也会受影响。
OpenResty提供的Cosocket则把网络I/O接入Nginx事件循环。代码看起来仍然是顺序的:
local redis = require"resty.redis"red:set_timeouts(100, 200, 200)local ok, err = red:connect("redis", 6379) ngx.log(ngx.ERR, "redis connect failed: ", err)local value, get_err = red:get("route:tenant-1001")local keepalive_ok, keepalive_err = red:set_keepalive(60000, 100) ngx.log(ngx.WARN, "keepalive failed: ", keepalive_err)
当connect()或get()等待网络时,Lua协程会yield,Worker可以继续处理其他请求;I/O就绪后再恢复协程。
这就是OpenResty能够用“同步写法”表达非阻塞I/O的关键。
但Cosocket不是魔法。生产代码至少要处理:
连接、发送、读取三类超时;
连接池大小与Keepalive;
DNS变化和失败重试;
上游半开连接;
返回值中的nil、ngx.null与错误字符串;
当前Nginx阶段是否允许yield。
最危险的做法,是在请求路径中调用io.open()、os.execute()或阻塞式LuaSocket。一次慢磁盘或慢网络,就可能卡住整个Worker的事件循环。
lua-nginx-module官方文档专门强调了“Cosocket并非在所有阶段都可用”。尤其在响应过滤和日志阶段,不要想当然地发起网络请求。
八、进阶能力四:动态路由不只是修改proxy_pass
local bucket = ngx.crc32_short(ngx.var.request_id) % 100local percent = ngx.shared.route_config:get("beta_percent") or0 ngx.var.backend = "backend-b:80" ngx.ctx.route = "backend-b" ngx.var.backend = "backend-a:80" ngx.ctx.route = "backend-a"
比随机数更重要的是稳定分桶。同一个用户应该尽量稳定地落到同一组,否则一次会话可能在新旧版本之间反复跳动。
生产系统通常会用用户ID、设备ID或租户ID做Hash:
bucket = hash(user_id) % 100
更进阶的做法是使用balancer_by_lua_block,在Nginx选择上游节点的阶段调用ngx.balancer.set_current_peer():
upstream dynamic_backend {local balancer = require "ngx.balancer" local peer = require("peer_selector").pick() local ok, err = balancer.set_current_peer(peer.host, peer.port) ngx.log(ngx.ERR, "set peer failed: ", err) return ngx.exit(ngx.HTTP_SERVICE_UNAVAILABLE)
这样可以结合服务发现、节点权重、失败次数、区域和租户信息动态选点。
但要守住一条安全边界:后端地址必须来自可信配置和允许列表。 如果直接把请求参数拼进上游地址,网关很容易变成SSRF跳板。
九、进阶能力五:定时任务为什么会执行多次?
init_worker_by_lua_block { require("config_sync").start()
如果有8个Worker,就可能同时启动8组定时器。
这对本地缓存预热可能没有问题,对“每分钟全量拉取配置”或“清理全局数据”却可能造成重复请求、惊群甚至竞争覆盖。
常见解决办法包括:
让任务天然幂等;
只允许worker.id()==0的Worker执行;
使用Shared Dict抢占带过期时间的Leader锁;
把真正的全局调度放到OpenResty之外;
Worker退出时检查ngx.worker.exiting(),不要继续注册新任务。
单Worker正确,不代表多Worker正确。OpenResty中的很多并发Bug,都来自忘记了“每个Worker是一套独立运行时”。
十、写Lua时最容易踩的8个坑
1.在请求中反复加载文件
使用require()加载模块。Lua会通过package.loaded缓存模块;不要在高频路径里反复dofile()。2.把Lua全局变量当成跨Worker共享内存
它只属于当前Worker,而且不受保护的全局可变状态很难推理。模块内部优先使用local。3.把Shared Dict当成无限缓存
容量固定后,写入可能失败或触发淘汰。每一次set()、add()都应该检查返回值,并监控剩余容量与淘汰次数。4.在Body Filter里拼接巨大字符串
响应体过滤是分块调用的。直接累加所有Chunk会制造高额内存复制,并让大响应失去流式优势。5.在Log阶段同步上报远程服务
日志阶段不适合直接做网络I/O。优先写标准日志,由Agent采集;确需异步处理时使用受控队列或定时器,并设计丢弃与背压策略。6.没有超时的外部调用
没有超时,就等于把网关可用性交给下游决定。连接、发送、读取应分别设定预算。7.把密钥硬编码进Lua
Demo可以这样做,生产不可以。密钥应从受控环境变量、挂载文件或密钥系统加载,并支持轮换。8.为了灵活,把所有逻辑都搬进网关
网关应该做横切能力和流量决策,而不是承载复杂订单状态机。越靠近入口,故障半径越大,代码越应该克制。十一、生产化检查清单
上线前,我会至少检查下面这些问题:
OpenResty和容器镜像是否锁定了明确版本;
openresty -t
Lua模块是否全部使用local并通过require()加载;
每个外部调用是否设置连接、发送和读取超时;
是否使用Cosocket兼容库,而不是阻塞式I/O;
Shared Dict是否按业务拆分,容量和淘汰是否可观测;
定时任务是否考虑多Worker重复执行;
限流Key、突发容量和失败策略是否经过压测;
动态上游是否经过允许列表校验;
日志是否包含Request ID、路由、状态码和延迟;
是否验证Reload过程中的共享状态、连接池和旧Worker退出;
是否准备绕过Lua逻辑的降级开关和回滚路径。
配置校验可以先执行:
docker compose exec gateway openresty -t
Lua模块可以使用resty命令做快速验证;更完整的Nginx阶段测试,则适合用OpenResty项目广泛采用的Test::Nginx测试框架。
性能测试也不要只看QPS。至少同时观察P99延迟、Worker CPU、Lua GC、Shared Dict淘汰、上游连接复用和错误分布。
十二、写在最后:OpenResty的边界,决定了它的力量
OpenResty最吸引人的地方,是它让基础设施拥有了业务感知能力。
它可以知道当前用户是谁、这个请求是否超额、应该进入哪个版本、哪些结果可以缓存,然后在请求抵达业务服务之前完成决策。
但它的力量并不来自“Lua什么都能写”。
恰恰相反,它来自对边界的尊重:
尊重Nginx的执行阶段;
尊重事件循环,拒绝阻塞I/O;
分清请求、Worker和跨Worker状态;
把复杂业务留给更合适的服务;
让网关只承担快速、稳定、可降级的决策。
当这些边界足够清晰时,Lua不再是一段塞进Nginx的脚本。
它会变成流量进入系统之前,那层轻巧但精确的控制平面。
用输出倒逼输入,用分享对抗遗忘。这里是“极客思享的成长日记”,我们下一篇继续拆底层。参考资料
本文Demo用于学习OpenResty执行模型,不包含完整的生产认证、密钥管理和服务发现实现。正式部署前请结合安全审计、容量测试与故障演练进行完善。
阅读原文:点击这里
该文章在 2026/10/16 16:10:42 编辑过


 400 186 1886